
OpenAI добавила режим Ultrafast для GPT-6.1 Sol в API. Он сокращает задержки между токенами при генерации ответа и предназначен для приложений, которым важна скорость обработки запросов.
Ultrafast оплачивается отдельно по повышенному тарифу: обработка токенов обходится в шесть раз дороже, чем в режиме Standard. При этом OpenAI не приводит конкретных показателей ускорения для GPT-6.1 Sol.
Как включить Ultrafast для GPT-6.1 Sol
Режим выбирают при отправке запроса через Responses API. Для этого нужно указать модель gpt-6.1-sol и параметр service_tier со значением ultrafast. Менять модель или перестраивать интеграцию для этого не требуется.
OpenAI рекомендует использовать WebSocket: постоянное соединение помогает сократить сетевые задержки между последовательными запросами. Это может быть полезно для агентов, которые многократно вызывают инструменты и передают результаты обратно модели. Обычные HTTP-запросы также поддерживаются.

Для Ultrafast действуют отдельные лимиты запросов и токенов. Они отличаются от ограничений режимов Standard и Fast. Проверить доступные лимиты можно в настройках организации в API.
Стоимость и доступность
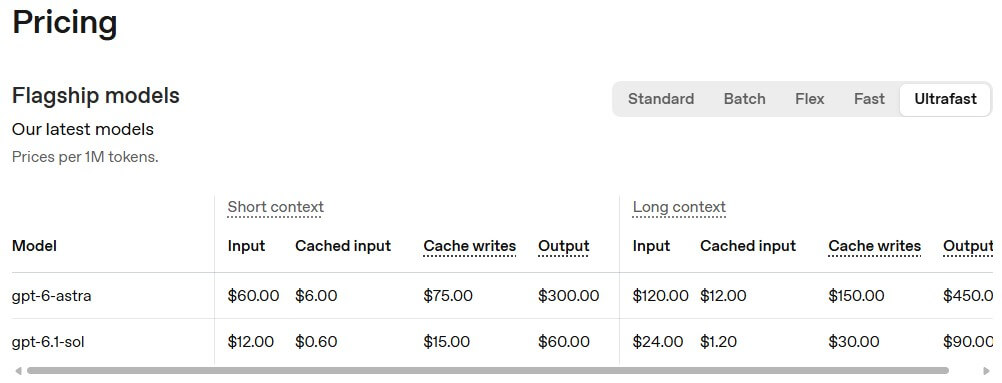
При объёме входного контекста до 272 000 токенов включительно миллион входных токенов в режиме Ultrafast стоит $12, а миллион выходных — $60. Входные токены — это данные, которые приложение передаёт модели, выходные — сгенерированный ответ. Для запросов с более длинным контекстом действуют повышенные тарифы.
Ultrafast для GPT-6.1 Sol поддерживает глобальную обработку данных, а также размещение данных в США или Евросоюзе. Доступные варианты зависят от настроек организации.
Режим также доступен для GPT-6 Astra. Для GPT-5.6 Sol он предоставляется в предварительном доступе.
Ранее OpenAI открыла GPT‑6 всем пользователям ChatGPT.
Скриншоты: developers.openai.com/api/docs/guides/ultrafast-mode
